最早的 AI,很像一張嘴。
你問,它答。資料交給它,它整理;圖片拿給它,它判讀。回答再周到,要讓事情發生變化,總還得有人去開啟下一個系統、執行下一道指令。
後來,AI 開始取得工具。它能依授權讀取資料庫、執行程式、操作既定介面,並把上一個步驟的結果帶進下一個判斷。原先一次性的問答,於是有機會接成一段工作回路。
回路接起來之前與之後,差別究竟在哪裡?
想像一家電子製造廠的夜班。凌晨兩點,例行報表顯示一條 SMT 產線的檢測合格率突然下滑。過去,值班工程師得打開報表,核對時間區間,查設備紀錄,再判斷要通知誰。現在工廠把前面幾個低風險步驟交給一套已設定權限的系統。
它先接到異常訊號,沒有立即宣布「設備出問題」。報表的分母忽然變大了,系統便依照預先核准的規則,啟動一個唯讀查詢,檢查同批資料是否被重複匯入。這個動作不需要一個特別聰明的模型;比對識別碼、去除重複列,再計算一次,普通程式便足夠。
重新計算後,整體數字確實回升,但其中一台設備的異常分布仍然偏高。
這時系統沒有把警報當成已經排除,也沒有私自修改設備參數。它讀取自己獲准查閱的設備事件紀錄,將前後兩次計算的依據一併附上,透過既定介面建立待查案件,送到值班工程師的工作清單。工程師打開案件時,看見的已經不是一句「良率下降」,而是原始警報、重複資料的影響、尚未排除的異常,以及下一步需要確認的項目。凌晨的值班室很安靜,他原本正要照往常打開另一份報表,現在卻停下來看了那台仍有異常的設備編號。他把案件留在螢幕上,起身往產線走去。資料核查替他省下一段路,現場判斷卻還得由他親自完成。
工程師仍要到現場判斷原因,是否停線或更改製程條件也不在這個系統的自行處置範圍內。
這是一個假設性的例子。真正值得注意的,也不是節省了幾次滑鼠點擊。
當系統發現第一份資料不可靠,它能依規則自行決定重查;重查仍有異常,它又能依條件建立案件、通知下一個處理者。每一步都留下一個可以檢查的結果,下一步才有新的依據。原來需要人逐一接手的小決定,有一部分移進了工作回路。
這和單純讓 AI 回答「可能原因有三種」,已經不同。
不過,一條回路也不必從頭到尾都交給最強大的 AI。
重複資料的辨識可以用程式;固定條件的警報可以用規則;整理跨系統證據可由合適的工具完成。只有當證據互相矛盾、情境陌生,或需要重新理解問題時,才值得引進更強的推理能力。
《明思》在這裡做的事相當樸素:把一件工作拆開,辨認哪些部分已知、哪些仍然未知,哪些需要判斷,哪些只需要可靠地執行。
事情需要多少未知,就喚醒多少能力。
這項原則也為人與 AI 留下真正的合作空間。能力可以依任務需要暫時加入,也可以在任務結束後退出;並沒有哪一個角色必須從頭到尾包辦所有步驟。
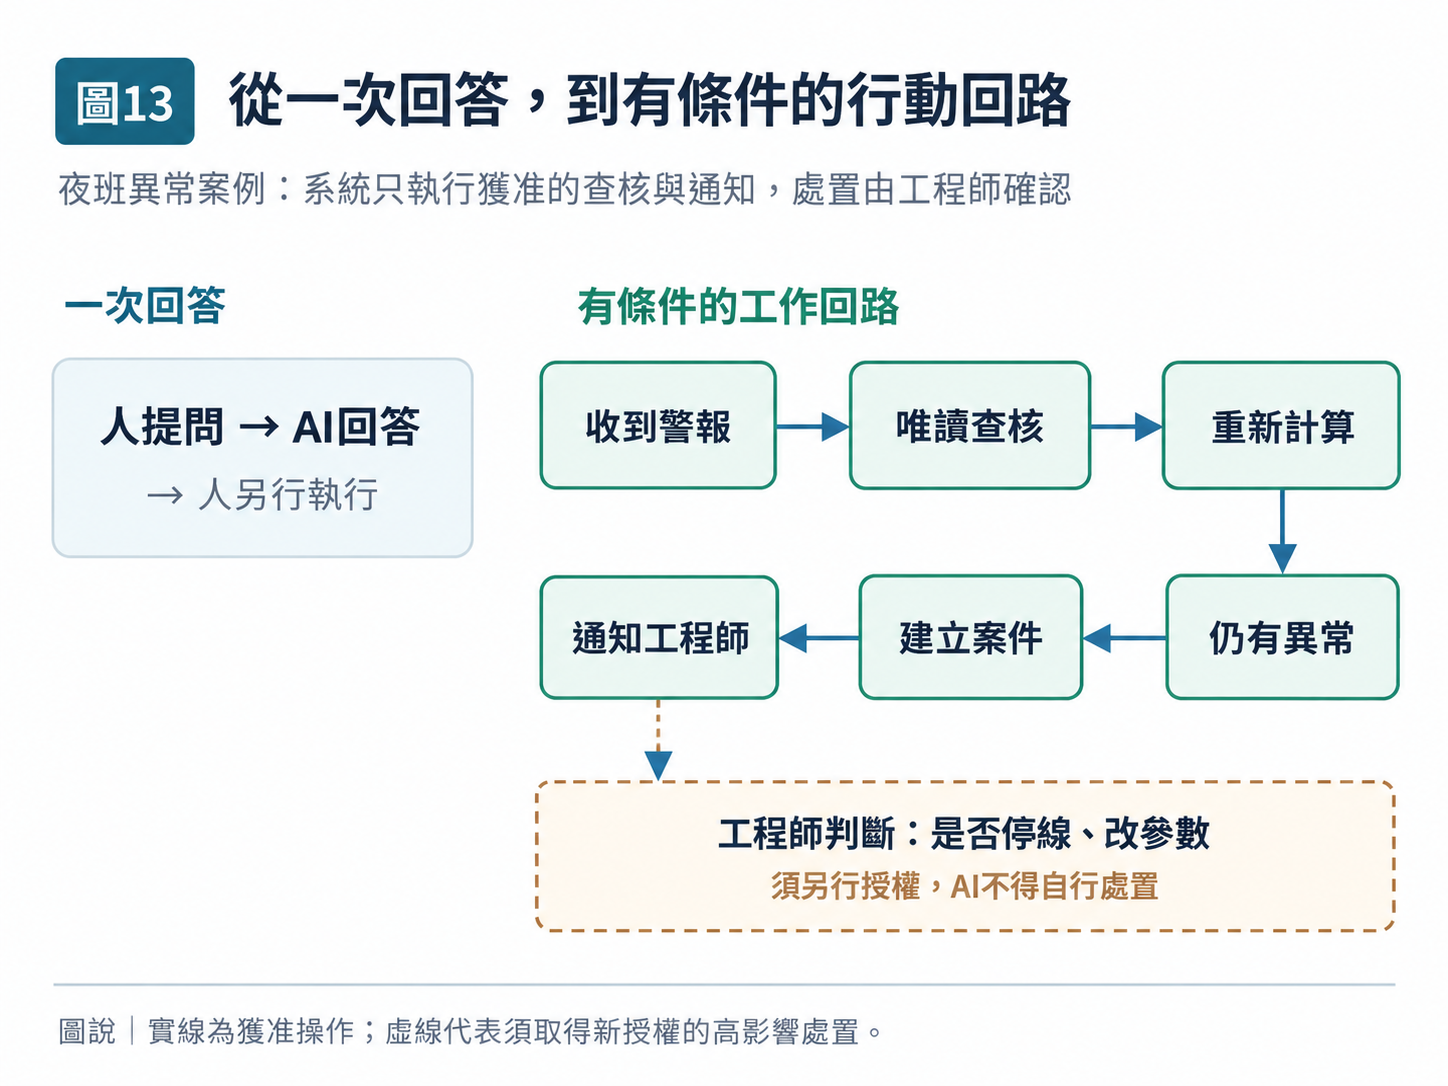
回到夜班現場,工程師未必需要再做一次相同的資料整理,但他也沒有失去判斷的位置。那份待查案件讓他較快接觸尚未解決的部分,而系統只能在已獲准的界線裡繼續工作。
從前,一個回答之後還要等人接上下一步。現在,有些下一步已經會在工作途中被決定、被執行,也被留下證據。這些小小的判斷一旦連起來,AI 就不再只是站在現實之外說話。
當 AI 能在工作途中自行決定一部分「下一步」,我們是否清楚界定了它此刻可以走到哪裡?