AI很會生成。
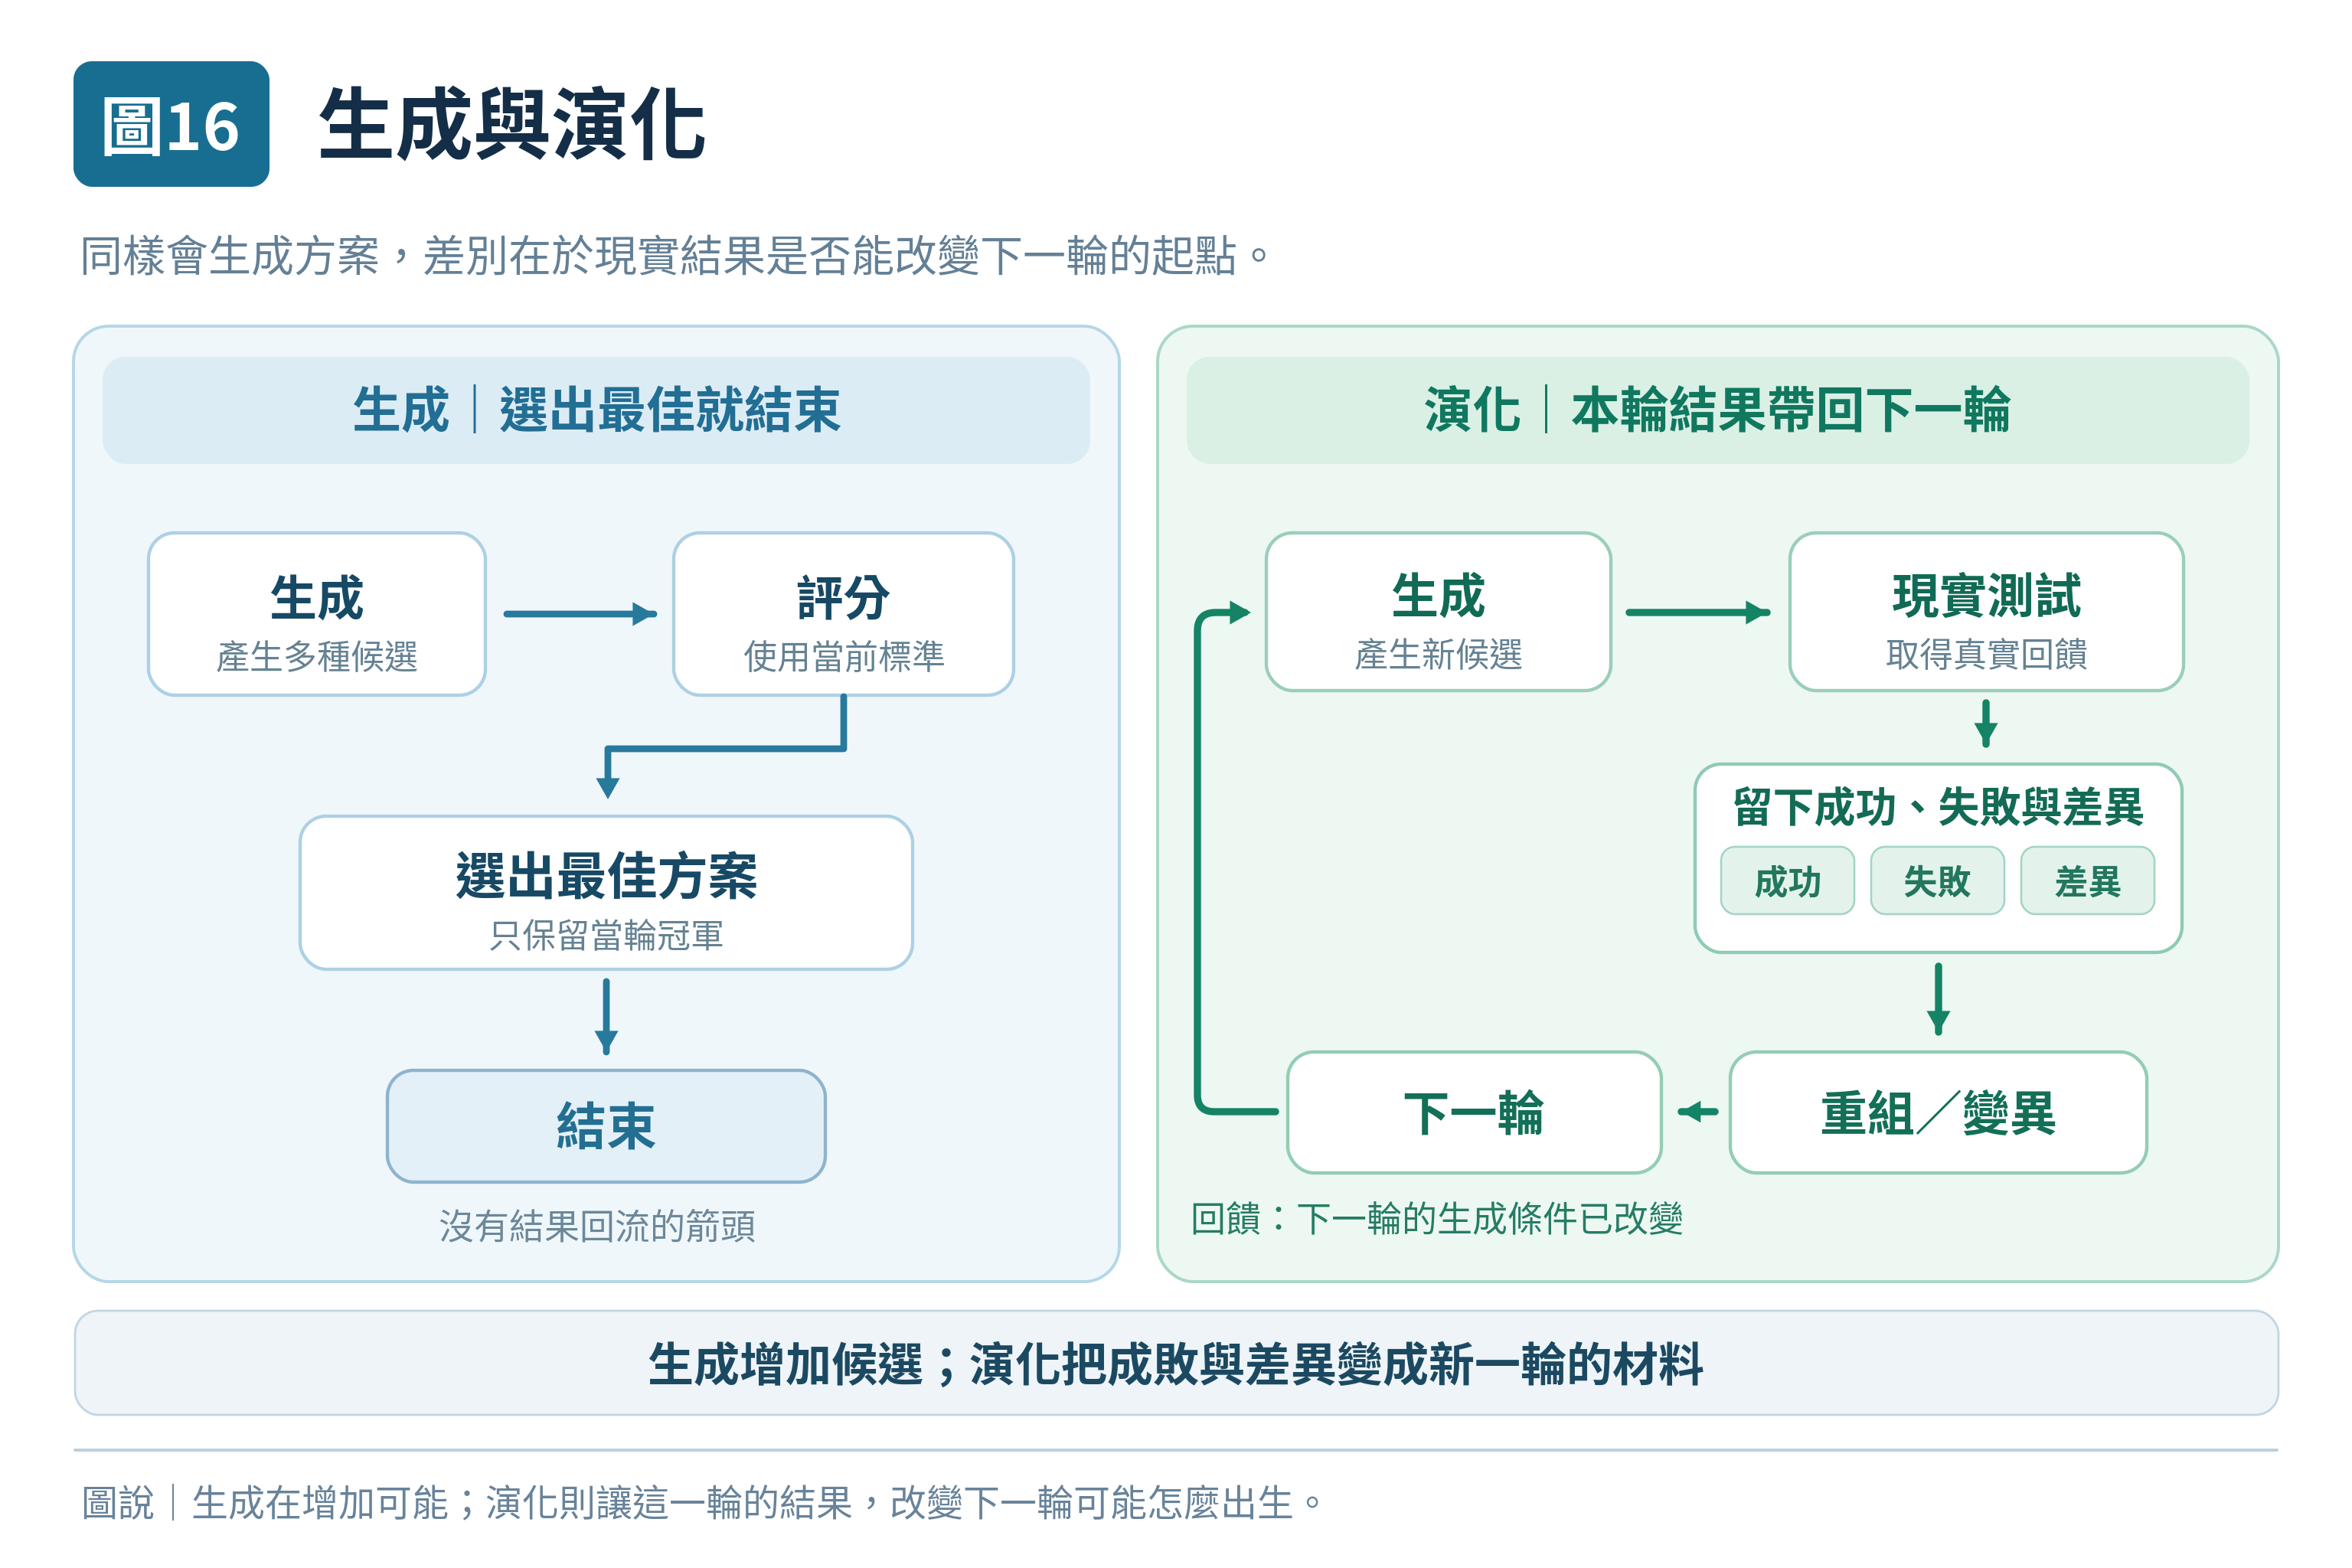
一次二十個方案,一次一百個。再來一輪,還可以更多。
但如果每一輪都只是重新開始,生成再多,也只是反覆抽籤。
真正的差別在於:
上一輪發生過的事,有沒有改變下一輪。
一組製程參數出了二十種方案。
實驗結果很清楚。
7號最好。
照一般流程,答案已經有了。
選7號,其餘十九個淘汰。事情結束。
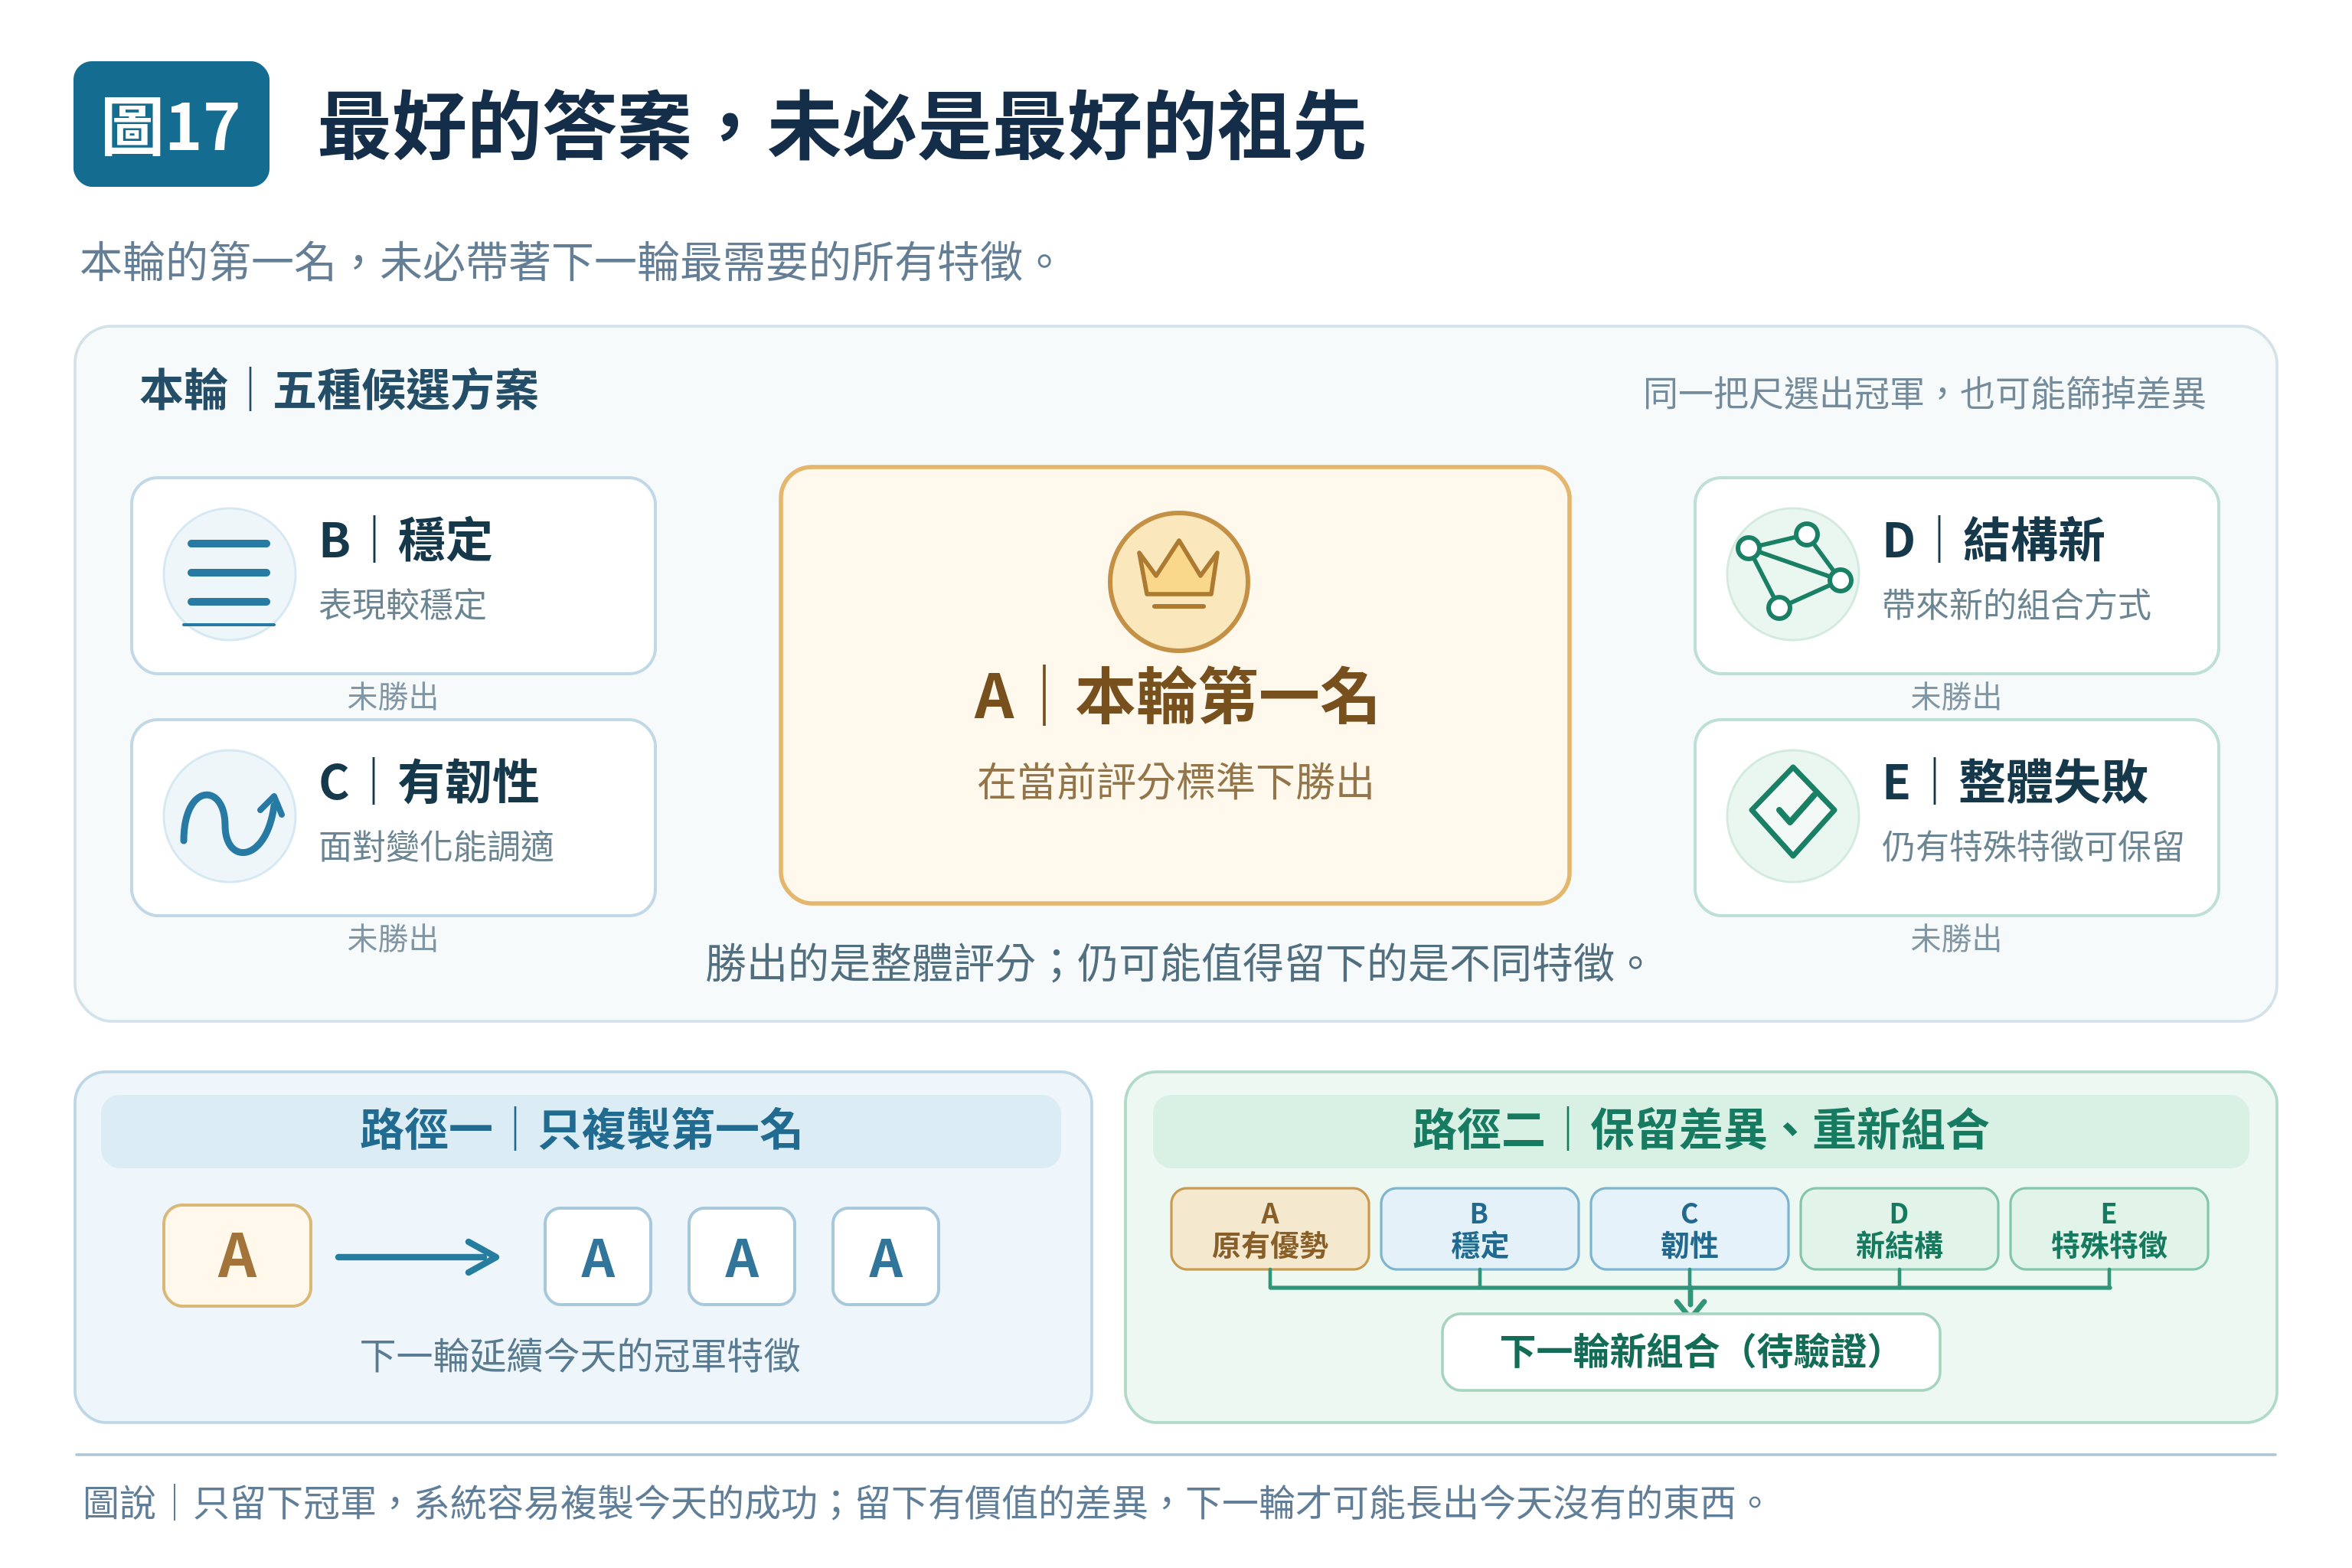
但如果再往下看,會發現另外幾個方案也留下了值得注意的東西。
12號整體成績普通,遇到材料波動時卻特別穩。
18號成本偏高,但對環境變化不敏感。
3號失敗得很明顯,可其中一組參數的搭配方式,以前沒人試過。
這時,《明思》不急著只留下冠軍。
它會問:
哪些結果值得?
哪些失敗只是失敗?
哪些失敗裡,藏著下一輪還值得再試的東西?
團隊於是把三種差異保留下來:日常最佳表現、材料波動下的穩定性,以及值得再次驗證的陌生組合。原先準備結案的工程師把7號留在報告首頁,又在後面多加了一頁:12號的波動紀錄、18號的環境條件,以及3號那組令人不放心卻尚未被排除的搭配。下一輪實驗不再只複製7號,而是根據這些差異設計新的候選,事先訂好判斷標準再測一次。
於是問題從:
「誰最好?」
變成:
「什麼值得進入下一輪?」
這兩個問題很不一樣。
7號可能是今天最好的答案。
卻不一定最適合長出明天的新方案。
因此有一句話值得記住:
最好的答案,未必是最好的祖先。
如果只複製冠軍,系統很快就會收斂。
收斂沒有錯。
問題是,有些還沒成熟的差異,也會一起被消掉。
真正的演化,需要的不只是選擇。
還要留下差異。
這時,《明思》的「」就不只是把資料存下來。
如果只是保存二十份結果,那是資料庫的工作。
真正有用的,至少要保留:
這個方案為什麼成功?
它在哪些條件下成功?
它在哪裡失敗?
哪一個特徵值得留下?
哪個原本被看好的判斷後來錯了?
哪個不起眼的差異,過了幾輪才開始顯出價值?
這些東西如果能進入下一輪,失敗就不只是被刪除。
它也可能成為下一輪的材料。
這就是開始改變未來的地方。
但演化很容易被浪漫化。
好像只要一直試、一直選,事情自然會越來越好。
未必。
如果每一輪都只用同一個KPI判斷:
成本最低。
速度最快。
良率最高。
那麼系統只會越來越擅長滿足那個KPI。
它不一定更好。
只是更適合那把尺。
所以《明思》的不能只對著方案。
還要回頭問:
誰在決定什麼叫做「更好」?
這才是選擇真正危險的地方。
因為選擇會留下某些東西。
也會讓另一些東西逐漸消失。
如果尺本身有問題,演化得越久,偏差可能越穩。
這裡也能看見《明思》的「」。
不是改答案。
是改變我們看答案的方法。
第一輪,我們也許只看平均表現。
第二輪發現,穩定性也很重要。
第三輪又發現,某些極端條件才真正決定成敗。
於是被留下來的,不只是一個方案。
連「什麼值得留下」這件事,也可能被修正。
這才開始接近真正的演化。
所以生成和演化之間,差的不是一個更大的模型。
而是一條歷史。
如果每一次都忘掉前一次,
AI再會生成,也只是一次次重新起跑。
這些結果可以保存在實驗紀錄、知識庫與下一輪工作流程中;除非另行訓練,並不意味語言模型會自改權重。
如果成功、失敗、差異、反例與修正能留下來,
下一輪就不再是同一個起點。
思考開始有前世了。
這也意味著,《明思》的不能只留在事情結束之後。
真正有力的地方,是它能回到下一輪開始之前。
讓下一次不必重新犯同一種錯。
也不必重新忘掉同一個被淘汰的可能。
於是:
保存差異。
檢查選擇。
調整標準。
再,讓新一輪重新展開。
這幾個動作接起來,生成才真正開始有方向。
不是被預先規定的方向。
而是被現實一輪一輪改寫的方向。
如果真正會演化的,不只是答案,而是「什麼值得留下、什麼值得淘汰」的選擇方式,那麼,我們究竟是在讓AI學習世界,還是在讓它愈來愈像我們現在用來評分世界的那把尺?